Day 26|替購物車寫支自動化測試

前言
前 25 天幾乎沒碰測試碼。Day 25 那支回歸測試是第一次動筆,而且是為了釘住一個 bug 才寫的。今天把它當起點正式寫測試,讓探索一次性找到的東西,變成每次都會重跑的東西。
開始之前
把測試放在第 26 天是刻意的。
寫腳本這件事,現在很便宜。你可以在 Day 2 就叫模型生一支會跑的 Playwright 測試,它會跑、會綠、看起來很像回事。真正的問題在下一層:這支測試在驗什麼,以及它綠的時候你能不能相信它。
前 25 天做的就是這件事。你先學會判斷什麼算異常、什麼算 bug、證據要留成什麼樣、結論怎麼被獨立重現。有了這些,你才知道哪一條路徑值得固化成測試,也才知道斷言該卡在哪裡。
順序反過來的後果很具體:先寫一大批測試,然後花整年維護一批你不確定在測什麼的東西。
還有一條決定要說清楚。多一支測試就是多一份要養一輩子的資產,所以 test-author 是 user-invoked,不讓模型在背景自己新增。該不該加,是人的決定。
動手試試
今天挑的是前幾天找出、驗過、也通過閘門的購物車問題:每一列的 Total 顯示 $00.00,頁尾總計卻是對的。
整套示範有四支測試:兩支驗登入,兩支驗購物車。下面先貼購物車的其中一支,檢查單列金額是否等於單價乘以數量;openFirstProduct、addToCart 等共用操作放在配套專案的 tests/fixtures/sut.ts,這裡只節錄測試本體。
test('購物車每一列的 Total 應該等於單價乘以數量', async ({ page }) => {
  const { name, price } = await openFirstProduct(page)
  await addToCart(page)
  await gotoCart(page)

  const row = page.locator('tbody tr').filter({ hasText: name }).first()
  const qty = Number(await row.locator('[data-test="product-quantity"]').inputValue())
  const unit = money(await row.locator('[data-test="product-price"]').innerText())
  const line = money(await row.locator('[data-test="line-price"]').innerText())

  expect.soft(unit, '商品頁與購物車的單價應該一致').toBeCloseTo(price, 2)
  expect(line, `${name}:${unit} × ${qty} 應該等於列總計(SUT=${SUT})`).toBeCloseTo(unit * qty, 2)
})
這次跑的是 Toolshop 的兩個公開版本:乾淨版 clean 與植入 bug 的 with-bugs。測試碼相同,用 SUT 環境變數切換目標;和昨天補跑修復時使用的本機環境是不同批實驗。執行整套四支測試:
npm run test:clean        # SUT=clean
npm run test:with-bugs    # SUT=with-bugs
跑完之後
同一份測試碼跑完,兩個環境交回的結果不一樣:
SUT=clean        4 passed
SUT=with-bugs    2 passed, 2 failed
下面這段失敗訊息來自另一支購物車測試,它檢查「各列金額加總是否等於頁尾總計」:
Error: 列總計相加 0 應該等於頁尾 14.15(SUT=with-bugs)
Expected: 14.15
Received: 0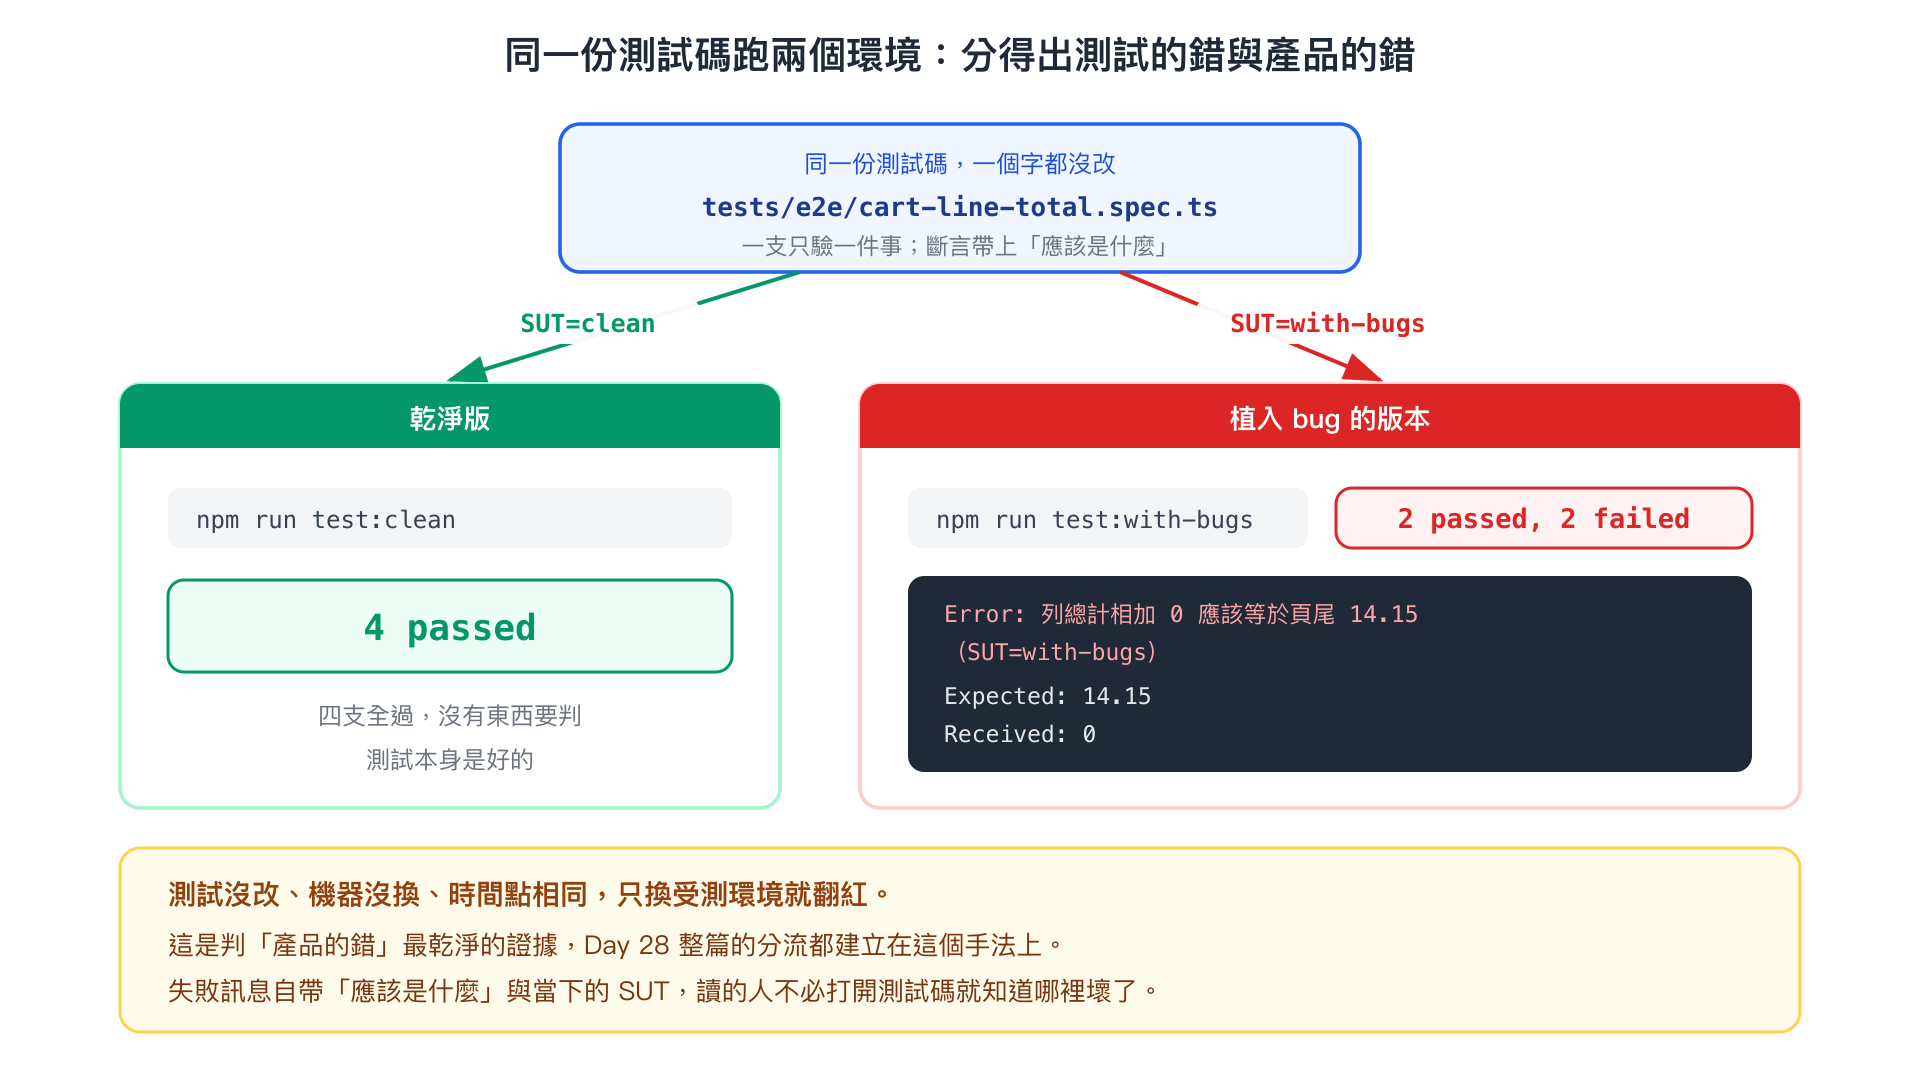
同一份測試碼跑兩個版本,方便我們對照差異。這次畫面正常載入,失敗點也和先前人工探索、獨立盲驗的金額問題一致,因此支持產品有缺陷的判斷。不能光看一邊紅、一邊綠就定案;明天和後天還會遇到環境與測試本身造成的紅燈。
順帶看那句失敗訊息。它沒有只丟一個 selector 逾時,而是把「應該是什麼」寫在裡面,還帶著當下的 SUT。讀失敗訊息的人不必打開測試碼,就知道哪裡壞了。
背後怎麼做
五條紀律
| # | 紀律 | 反例 |
|---|---|---|
| 1 | 一支只驗一件事 | 把登入、加購、結帳串成一支長流程 |
| 2 | 名稱寫使用者看到什麼 | 「點擊 apply 按鈕」 |
| 3 | 定位器優先序:測試專屬屬性 > 角色與可見文字 > 其他 | div:nth-child(1)、深層 XPath、自動產生的 id |
| 4 | 等待用 web-first assertion(會自動重試) | 拿 waitForTimeout 當等待手段 |
| 5 | 會變動的資料不硬編 | 把商品名、價格、id 寫死在測試裡 |
第 3 條有個前置動作:動筆前先跑 tests/tools/probe-selectors.ts,看看頁面實際提供哪些 data-test,不要用猜的。本例使用的屬性名來自探查結果;換一個專案,也要先確認它採用的命名慣例。
第 5 條如果需要固定測資,就交給負責測資的流程準備:開始前透過 API 建立,加上唯一標記避免和別人撞資料,結束後再清掉自己建立的部分。
還有一條寫在紀律之外但同樣硬的:帳密與 token 一律走環境變數,不得寫進測試檔。本專案的登入測試沒設環境變數就自動 skip,祕密不落地。
交付前的驗收
寫完不算完,交付前自問四題,過不了就重寫:
- 這支壞掉時,讀失敗訊息的人不看程式碼能不能懂哪裡壞了?
- 它自備自清嗎?跟別支有順序相依嗎?
- 跟現有測試重複嗎?重複就別新增。
- 把預期值故意改錯要紅,改回來要綠。
第 4 題是在確認斷言有沒有真的執行:預期值故意寫錯卻仍然全綠,就要查是不是根本沒走到那一行。檢查完要把預期值還原。不過,這只能證明斷言會抓到差異;昨天的先紅後綠,還要確認它抓到的正是那顆產品 bug,兩件事不能完全畫上等號。
風格的部分交給設定檔。Page Object 要不要用、選擇器優先序、導頁方式、斷言與命名慣例,寫在 config/test-style.md,動筆前先讀。縮排、引號、import 順序那些交給 linter,確定性的事情不要花 token 叫模型記。
今天學到什麼
今天把探索時發現的購物車金額問題,寫成可以反覆執行的測試。同一套測試跑兩個版本,再對照失敗訊息和先前的證據,確認測試確實抓到了要看的問題。
寫完會跑還不夠,也要檢查它是不是靠猜來的選擇器、是不是把會變的商品資料寫死,以及失敗時別人能不能看懂。故意改錯預期值,是檢查斷言有沒有執行;抓到真實缺陷,還需要正確的判斷依據。
明天把這套測試接進 GitHub Actions,讓相關程式碼更新時自動跑。報告和證據也要一起留下來,免得紅燈亮了,大家只知道「壞了」,不知道從哪裡查。
參考資料
- Gerard Meszaros(2007)《xUnit Test Patterns: Refactoring Test Code》 - 測試碼本身也是要維護的資產,書裡的 test smell 目錄正是五條紀律的來源
- Playwright Docs — Best Practices - user-facing locator、web-first assertion、避免測試互相依賴的官方立場
- Playwright Docs — Auto-waiting - 為什麼 web-first assertion 可以取代固定等待
- Martin Fowler(2011)《Eradicating Non-Determinism in Tests》 - 不確定的測試比沒有測試更糟,第 4、5 條紀律的依據
- 本專案
references/test-design.md、config/test-style.example.md(專案自己的測試風格)、tests/e2e/cart-line-total.spec.ts- 本篇的實測主角